Enseñanza de lengua de señas con un brazo robótico interactivo y retroalimentación visual en tiempo real: qué propone este protocolo
La falta de dominio de la lengua de señas (LS) en la población general y en las instituciones sigue limitando el acceso de las personas sordas a la educación, la salud y los servicios legales. Un equipo de la Universidad Tecnológica Indoamérica (Quito, Ecuador) publicó en PLoS One un protocolo de estudio para evaluar un sistema de tutoría de la Lengua de Señas Ecuatoriana (EcSL). El sistema combina visión por computadora, inteligencia artificial en el borde (edge AI) y un brazo robótico que entrega una recompensa física. Todavía no hay resultados: es un protocolo, no un ensayo finalizado. Aun así, ofrece ideas interesantes sobre retroalimentación inmediata, motivación y aprendizaje motor.
Por qué importa para entrenadores, kinesiólogos y deportólogos
La lengua de señas exige precisión motriz fina, coordinación bimanual, control postural y expresión facial. Se describe con cinco parámetros fonológicos: configuración de la mano, orientación de la palma, ubicación, movimiento y componentes no manuales. El estudio añade la coordinación global como sexta variable. Estas exigencias son análogas a las del aprendizaje de gestos técnicos en el deporte y la rehabilitación, donde también se busca corregir la ejecución con feedback objetivo e inmediato.
Diseño del estudio
- Tipo: experimento aleatorizado de dos brazos, con pretest y postest y grupo control (diseño mixto 2×2: grupo × tiempo).
- Muestra: 70 estudiantes universitarios sin formación previa en EcSL (35 por grupo), calculada con G*Power (η² = .15, α = .05, potencia = .90, seis variables dependientes).
- Asignación: 1:1 con secuencia generada por computadora en R y sobres opacos sellados. El evaluador experto en EcSL desconoce el grupo asignado (ciego).
- Grupo control: no recibe intervención durante el estudio. Esto limita la interpretación: no permite separar el efecto del robot del de la retroalimentación visual ni del de simplemente practicar.
- Calendario previsto: reclutamiento en noviembre de 2026, recolección de datos hasta diciembre de 2026 y resultados preliminares en enero de 2027.
Variables de resultado
Un experto puntúa cada seña con una rúbrica de tres niveles (0 = incorrecta, 1 = parcialmente correcta, 2 = correcta) en seis parámetros: configuración de la mano, orientación de la palma, ubicación, movimiento, señales no manuales y coordinación global. Los puntajes se promedian por participante.
Análisis estadístico
El análisis principal es un MANOVA mixto de medidas repetidas, con foco en la interacción grupo × tiempo. Si resulta significativa, seguirán ANOVA univariados con corrección de Bonferroni y análisis de efectos simples. Se informarán el eta cuadrado parcial y la d de Cohen. Como chequeo de robustez se usarán pruebas no paramétricas (Wilcoxon y Mann–Whitney).
La intervención: tres sesiones, 16 señas de frutas
Los participantes asisten a tres sesiones de laboratorio de hasta 12 minutos cada una. Aprenden 16 señas de frutas, agrupadas por dificultad creciente:
| Sesión | Contenido | Duración estimada |
|---|---|---|
| 1 | 6 señas de dificultad moderada-baja, con familiarización con la plataforma | ~12 min |
| 2 | 6 señas de dificultad intermedia | ~10 min |
| 3 | 4 señas más complejas | ~7 min |
El orden de presentación de las frutas dentro de cada sesión es aleatorio, para minimizar los efectos de orden.
El ciclo de aprendizaje por seña
- Video de referencia: un señante experto ejecuta la seña en bucle (10 repeticiones), sin retroalimentación de cámara.
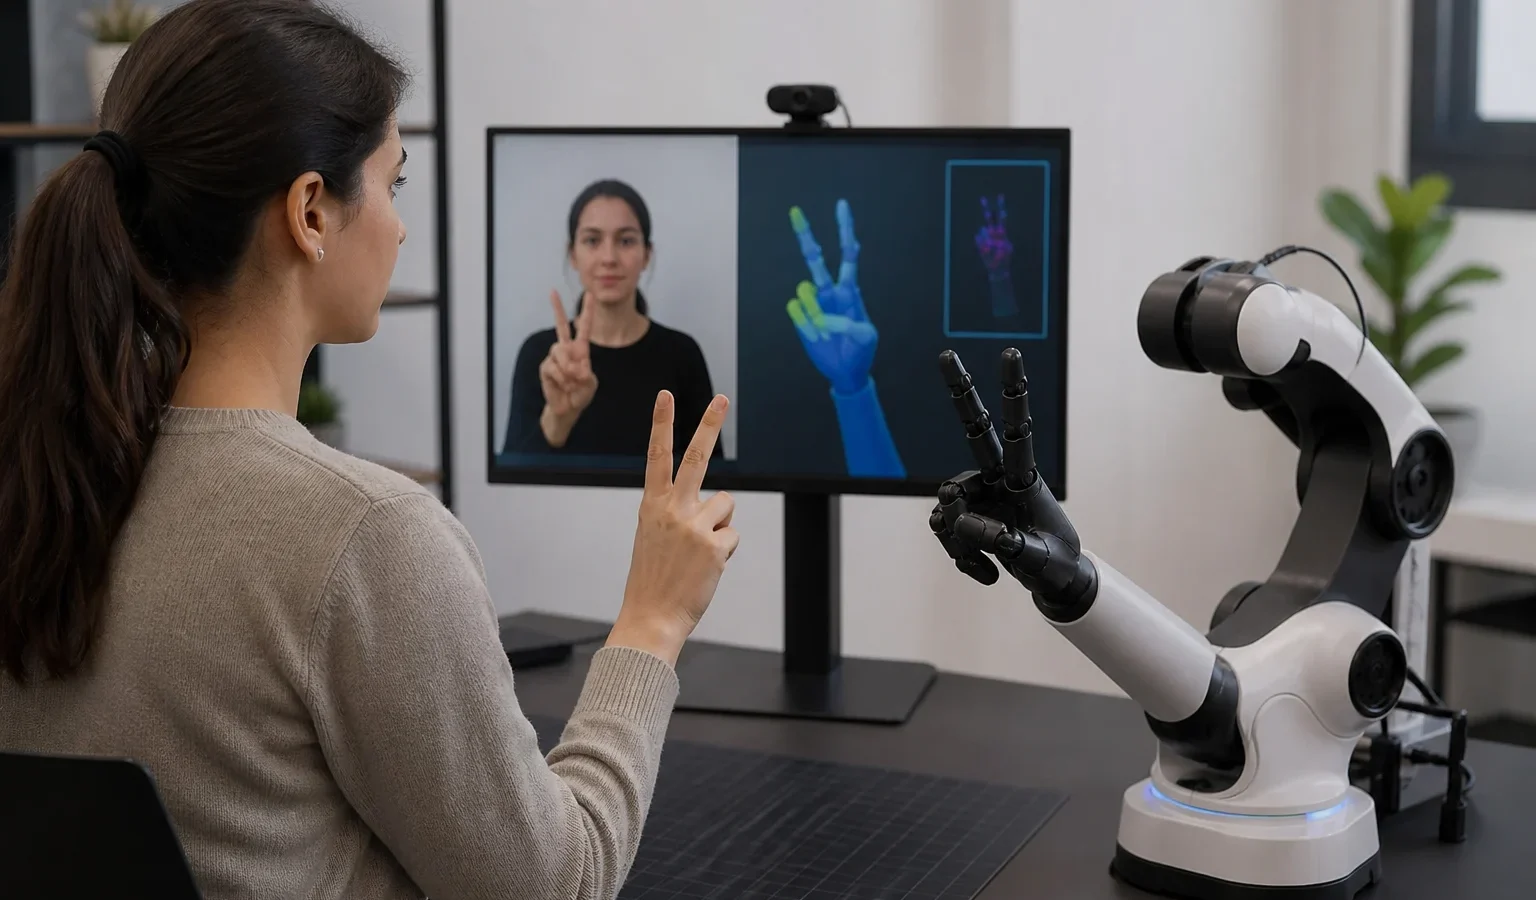
- Práctica con feedback en tiempo real: tres intentos de 5 segundos. La pantalla muestra la cámara en vivo, el porcentaje de precisión del reconocimiento y un temporizador. Un intento es exitoso si alcanza al menos 80 % de precisión. Hay indicadores por intento y por fruta (verde, amarillo o rojo) y mensajes como reposicionar las manos.
- Video de refuerzo: la seña aparece dentro de una oración subtitulada.
- Interacción con el robot: la respuesta depende del desempeño.
- 3 intentos exitosos: el brazo toma el bloque 3D de la fruta y lo apila en una zona de entrega. Con seis aciertos se forma una pirámide.
- 1–2 aciertos: el robot asiente.
- 0 aciertos: el robot niega con la cabeza.
Cada intento se registra en un CSV (fruta, precisión máxima, duración y resultado), lo que genera datos objetivos de progreso.
Tecnología: cómo funciona el reconocimiento
Hardware y arquitectura
- Procesador edge: NVIDIA Jetson Orin NX de 16 GB, sin servidor externo.
- Brazo robótico: myCobot 280, de seis grados de libertad, con carga útil de hasta 250 g y cámara RGB de 640×480 en la pinza.
- Software: interfaz en PyQt y módulos comunicados mediante ROS Noetic (nodos de interfaz, reconocimiento y control del robot).
Modelo de reconocimiento
Se extraen landmarks con MediaPipe Holistic (pose, manos y rostro) y se clasifican con un modelo de fusión de dos ramas:
- una LSTM bidireccional con atención temporal sobre secuencias de landmarks locales;
- un codificador de movimiento ST-GCN preentrenado en ASL Citizen (2.731 clases de señas), cuyo conocimiento se transfiere sin asumir equivalencia entre ASL y EcSL.
El entrenamiento usó 72 videos de 16 frutas, realizados por cinco señantes (del corpus abierto AI-Ready EcSL), con aumento de datos online. La validación fue de tipo leave-one-signer-out anidada, es decir, siempre con un señante no visto. Los resultados fueron:
| Métrica (fuera de muestra) | Valor |
|---|---|
| Exactitud | 81,94 % |
| Precisión macro | 84,67 % |
| Recall macro | 81,35 % |
| F1 macro | 81,15 % |
| Exactitud top-3 | 90,28 % |
Son cifras razonables para un vocabulario reducido, pero con solo cinco señantes y 16 clases el propio equipo califica de exploratorios algunos análisis, como el del efecto del aumento de datos.
Limitaciones a tener en cuenta
- Es un protocolo sin resultados: no hay evidencia aún de eficacia.
- El grupo control pasivo no aísla el componente robótico. Un diseño ideal incluiría un grupo con feedback visual sin robot.
- El umbral de 80 % es una confianza del clasificador, no una medida directa de calidad lingüística. Además, el modelo se entrenó con pocos señantes y puede generalizar con dificultad a principiantes.
- Se evalúa el aprendizaje inmediato (postest) y no la retención a largo plazo.
- La muestra es de estudiantes universitarios oyentes, no de personas sordas, y el vocabulario es acotado (frutas).
- La evaluación depende de un único experto, y el protocolo menciona chequeos de fiabilidad solo “cuando corresponda”.
Conclusiones y aplicaciones prácticas
- Feedback inmediato y cuantificado: el esquema de intentos breves con porcentaje de precisión en pantalla es transferible al aprendizaje de gestos técnicos, la reeducación motriz y los ejercicios de rehabilitación con cámara.
- Recompensa corpórea: la pirámide de bloques materializa el progreso. Es una estrategia de gamificación interesante para sostener la adherencia en poblaciones pediátricas, geriátricas o en rehabilitación prolongada.
- Tecnología accesible: una cámara RGB, MediaPipe y un procesador edge sin conexión a la nube muestran que el análisis de movimiento con landmarks es viable fuera del laboratorio, con costos moderados y mayor privacidad (las imágenes no se almacenan).
- Dosificación estructurada: progresión de dificultad, orden aleatorio, observación seguida de práctica con feedback y refuerzo contextual son principios aplicables al diseño de sesiones de aprendizaje motor.
- Registro objetivo: los CSV por intento permiten monitorear la evolución individual, algo valioso para preparadores y terapeutas.
- Esperar resultados: conviene seguir la publicación de los hallazgos antes de adoptar este enfoque, y en especial ver si la recompensa robótica aporta más que el feedback visual por sí solo.
El código y el conjunto de datos están disponibles en Zenodo bajo licencia CC BY 4.0, lo que favorece la replicación y la adaptación a otros contextos de enseñanza de movimiento.